Cómo arreglé Redis en producción y aprendí tres lecciones de Docker
Los logs de producción no perdonan. Un error repetido sin pausa es la señal definitiva de que algo está mal configurado.
[RedisModule] Reconnecting to Redis...
[RedisModule] Redis error: WRONGPASS invalid username-password pair or user is disabled.
Las credenciales eran correctas. Redis respondía bien desde su propio contenedor. Pero la aplicación no podía autenticarse. ¿Qué estaba pasando?
El problema inicial
El mensaje de error era claro: autenticación fallida. Pero la causa no era un password equivocado — era un problema más sutil de cómo Docker ejecuta comandos y cómo resuelve nombres en redes compartidas.
Redis es como el sistema nervioso de una aplicación: rápido, omnipresente, pero cuando falla, los síntomas aparecen en lugares inesperados. Aquí está cómo tres bugs me enseñaron más sobre Docker de lo que esperaba.
Bug #1: Shell redirection en docker-compose
El primer problema estaba en el docker-compose.yml. La configuración usaba el bloque > de YAML para pasar argumentos al servidor:
command: >
  redis-server
  --user zettasres on >pass ~* +@all
El > de YAML es un folded scalar — convierte el bloque en una sola línea que se pasa a través de /bin/sh. El problema: el shell interpreta >pass como redirección de salida (crea un fichero con ese nombre) en lugar de como parte de la configuración ACL de Redis.
El usuario zettasres nunca se llegaba a crear.
⚠️ Nota sobre ACL: Los comandos mostrados corresponden a la sintaxis de Redis 7.x usada en este entorno. Verifica siempre contra documentación oficial de Redis ACL para tu versión.
Solución
Evitar el shell por completo y montar el fichero redis.conf directamente como volumen:
command: redis-server /etc/redis/redis.conf
volumes:
  - ./redis.conf:/etc/redis/redis.conf:ro
Bug #2: Colisión de nombres DNS con Mailcow
Corregido el primer bug, el error persistía. Al investigar más a fondo, descubrimos que el hostname redis resolvía a una IP diferente a la del contenedor de Redis de la aplicación:
redis resolves to: 172.22.1.249 ← contenedor de Mailcow
Redis container: 172.26.0.2 ← nuestro Redis
El servidor de correo Mailcow tiene su propio contenedor Redis en la red compartida. Como la aplicación también estaba conectada a esa red (necesario para enviar email), el DNS resolvía redis al Redis de Mailcow — que lógicamente rechazaba nuestras credenciales.
Solución
Renombrar el servicio en docker-compose.yml de redis a zettas-redis para evitar la colisión:
services:
  zettas-redis:
    image: redis:7-alpine
    # ...
Y actualizar la URL de conexión:
REDIS_URL=redis://zettasres:password@zettas-redis:6379Mejora: Sesiones de verificación en Redis
El módulo de verificación de agentes IA usaba un Map en memoria para almacenar sesiones de 90 segundos, con un comentario explícito en el código: "replace with Redis for production".
Migramos las sesiones a Redis para que sobrevivan reinicios del contenedor, usando cache.set() con TTL nativo — Redis expira las claves automáticamente, eliminando el setInterval de limpieza manual.
ResilientCacheService: Caché con fallback automático
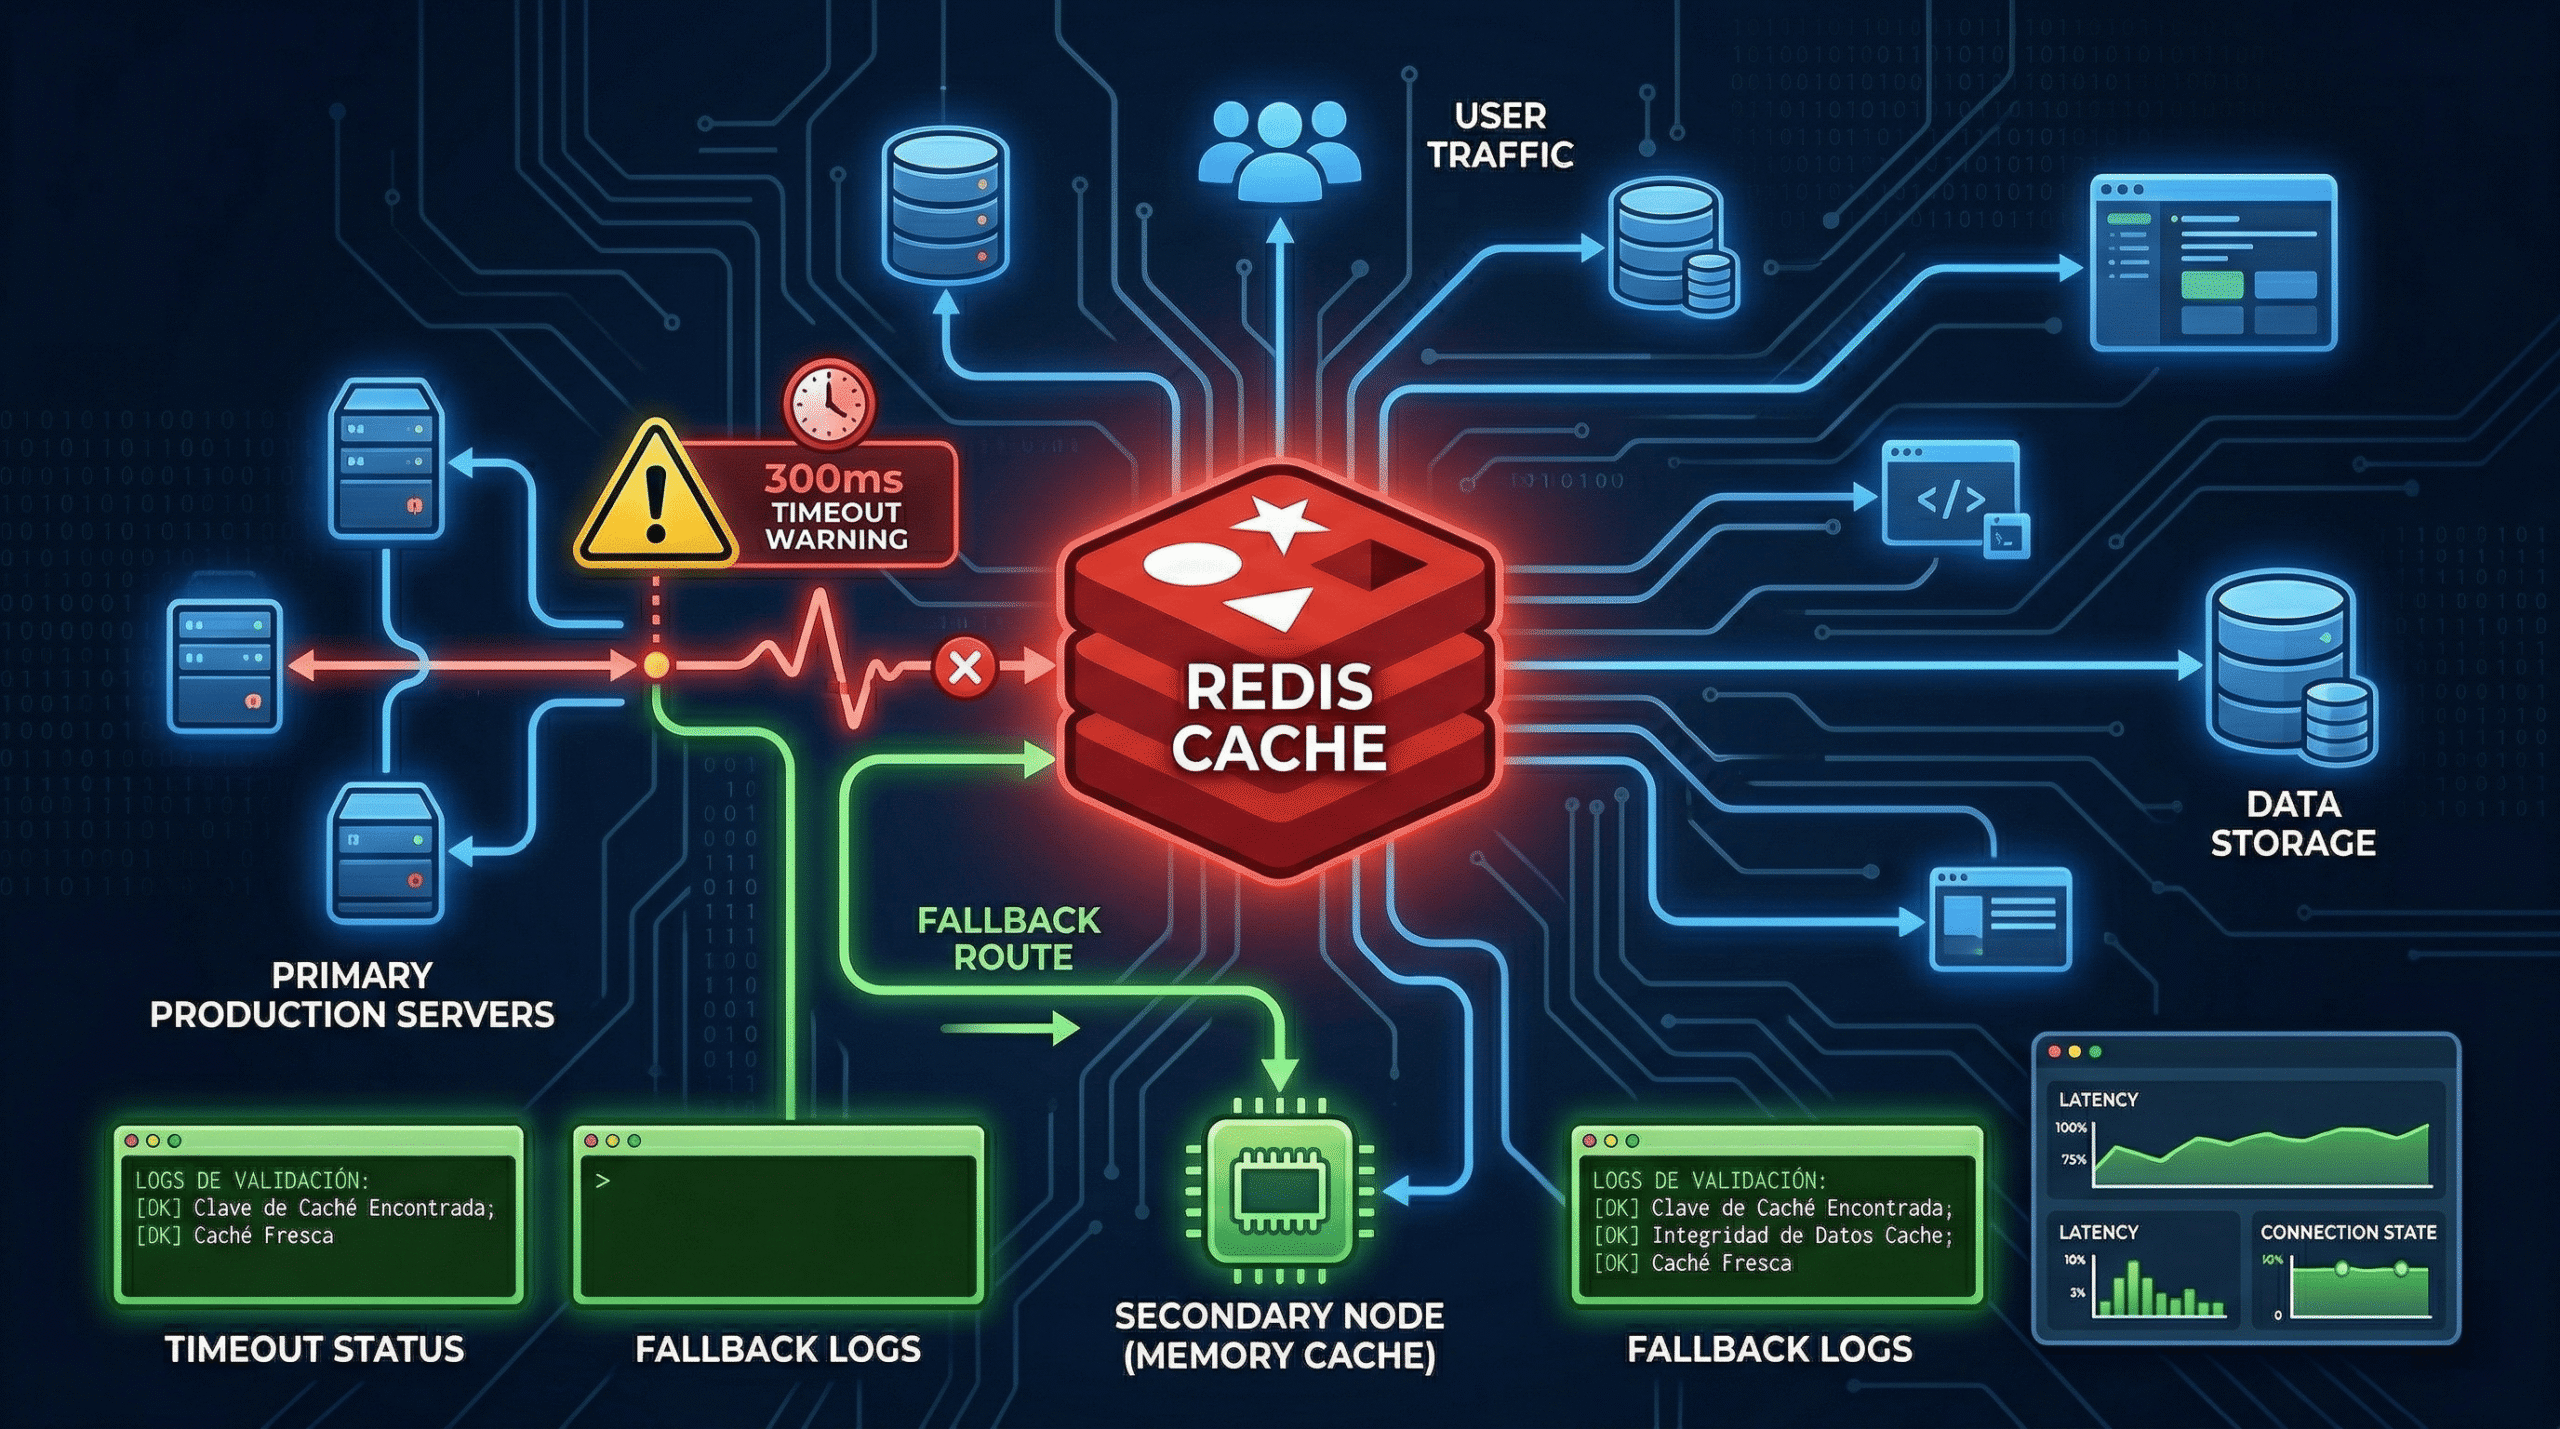
Tanto el módulo de configuración del sistema como el de verificación de agentes seguían el mismo patrón: intentar Redis, capturar el error, continuar sin caché. En lugar de repetir ese código en cada servicio, creamos un servicio centralizado.
@Injectable()
export class ResilientCacheService {
  async get<T>(key: string): Promise<T | undefined> {
    try {
      return await this.withTimeout(this.cache.get<T>(key)) ?? undefined;
    } catch {
      return this.fallback.get(key)?.value as T | undefined;
    }
  }
  // set() y del() con la misma lógica
}
El servicio vive en RedisModule, que es @Global() en NestJS, por lo que está disponible en toda la aplicación sin imports adicionales.
Patrones de resiliencia aplicados: Esta implementación combina Fallback pattern (caer a memoria local) con Timeout pattern (300ms). Para producción de alta criticidad, considera añadir Circuit Breaker (ej: librería
opossum) para evitar latencia cascada y Exponential Backoff con jitter en el timeout.
Bug #3: El offline queue de node-redis
Al probar el fallback apagando Redis, las peticiones se colgaban indefinidamente. El try/catch nunca se ejecutaba.
El motivo: cuando Redis cae estando conectado, @redis/client (la librería subyacente) no lanza un error de inmediato — pone las operaciones en cola esperando reconexión. El catch no llega a capturarse nunca.
Solución
Envolver cada operación con un Promise.race() contra un timeout de 300ms:
private async withTimeout<T>(promise: Promise<T>): Promise<T> {
  return Promise.race([
    promise,
    new Promise<never>((_, reject) =>
      setTimeout(() => reject(new Error('Redis timeout')), 300),
    ),
  ]);
}
Si Redis no responde en 300ms, el timeout lanza el error, el catch lo captura y la operación cae al Map en memoria. La aplicación sigue funcionando.
Resultado final
- Redis funciona correctamente en producción con autenticación ACL
- Las sesiones de verificación son persistentes entre reinicios
- Cualquier servicio puede usar
ResilientCacheServicecon tres métodos (get,set,del) sin preocuparse por la disponibilidad de Redis - Si Redis cae, la aplicación degrada graciosamente a memoria local en menos de 300ms
Lessons learned
Redis en producción es más que configurar credenciales y tirar de cable. Docker añade capas de complejidad que pueden ser invisibles en local pero catastróficas en producción.
- Evita shells en comandos de Docker — montar archivos de configuración como volúmenes es más seguro y predecible.
- Nombres DNS pueden colisionar — en redes compartidas, usa nombres específicos para evitar conflictos con otros servicios.
- La resiliencia hay que diseñarla — la cola offline de node-redis es útil en algunos casos, pero para caché quieres fail rápido, no esperas infinitas.
Ahora Redis hace lo que se supone que debe hacer: almacenar datos rápido y fallar con gracia cuando no puede. Y eso es todo lo que puedes pedirle a tu sistema nervioso.