Introducción
La mayoría de tutoriales sobre sistemas de upload te muestran cómo recibir un archivo, validarlo y guardarlo en disco o en un bucket S3. Funciona, pero escalar eso a producción es otra historia.
Cuando implementas un sistema real, te encuentras con problemas que los ejemplos simples no cubren:
- ¿Qué pasa si el usuario envía un archivo .exe con extensión .jpg?
- ¿Cómo evitas que alguien suba un GIF de 500MB que colapsa tu servidor al procesarlo?
- ¿Cómo evitas race conditions cuando múltiples solicitudes confirman el mismo upload?
- ¿Cómo controlas el ancho de banda para que un usuario malintencionado no drene tu cuota?
En este post, te muestro cómo implementar un sistema completo de upload a Cloudflare R2 en NestJS con múltiples capas de seguridad. No es código para copiar y pegar — es un enfoque con decisiones que funcionan en escenarios reales.
Por qué R2? Compatible con S3 API, sin egress fees, CDN integrado con Cloudflare, y pricing predecible. Perfecto para proyectos que escalarán.
Arquitectura del flujo
El flujo no sigue el modelo tradicional de «recibir archivo en el servidor → validar → guardar». En su lugar, usamos presigned URLs que delegan el upload directamente a R2. El backend nunca toca los bytes raw durante el upload:
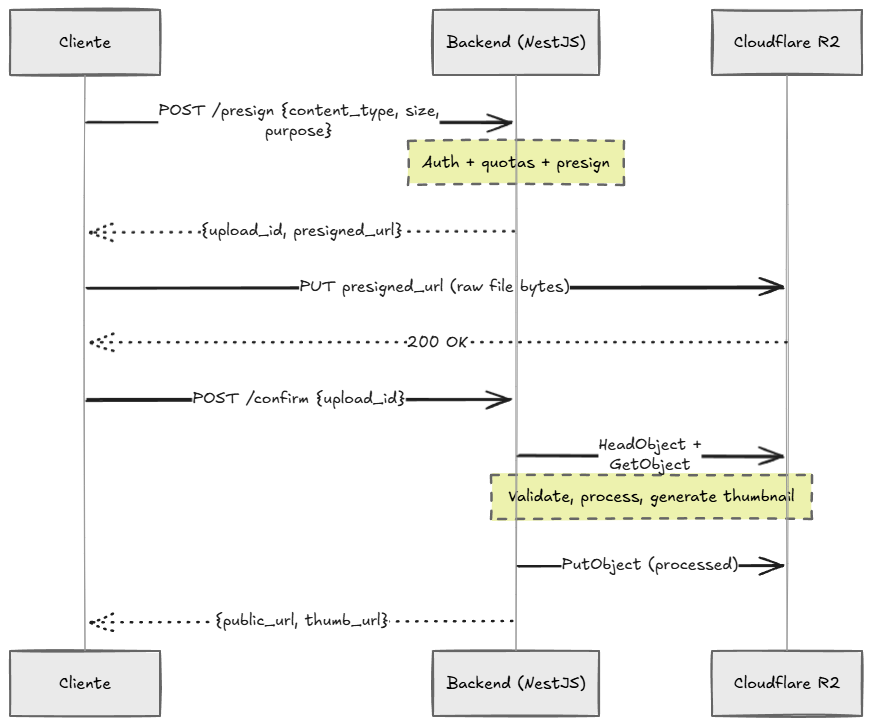
- El cliente solicita una URL pre-firmada — el servidor valida la solicitud (auth, quota) y genera una URL de upload directo a R2
- El cliente sube el archivo directamente a R2 usando esa URL — tu servidor ni ve el archivo
- El cliente notifica al servidor que el upload está completo
- El servidor confirma, valida magic bytes, procesa la imagen (strip EXIF, thumbnail) y re-sube a R2
- Un cron de limpieza elimina uploads pendientes expirados cada 10 minutos
¿Por qué este flujo? Tu servidor nunca procesa el upload real. Solo valida, coordina y procesa tras la confirmación. Si tienes 100 uploads simultáneos de 10MB, tu servidor procesa cero de esos megabytes durante la subida.
Endpoints
El sistema expone tres endpoints REST:
- POST /api/uploads/presign — solicita una URL de upload pre-firmada
- POST /api/uploads/confirm — confirma y procesa el upload
- DELETE /api/uploads/:id — elimina un upload existente
Todos requieren autenticación (JWT, API key, o el mecanismo que uses). El actor ID se extrae siempre del token autenticado — nunca del request body. Esto previene cualquier operación cross-actor.
Las capas de seguridad
1. Autenticación
Todos los endpoints requieren autenticación. El actor ID se extrae siempre del token. No existe ningún parámetro en el request para especificar un actor destino. Un actor nunca puede afectar los uploads de otro.
2. Scoping de presigned URL
La URL firmada está bloqueada a parámetros exactos:
- Content-Type y Content-Length declarados en presign — el cliente no puede cambiarlos sin invalidar la firma
- R2 key específico:
actors/{actorId}/{purpose}/{uuid}.{ext}— un actor solo puede escribir en su propio prefix - TTL de 5 minutos — tiempo suficiente para un upload normal, no para compartir o abusar
- Metadata
{ 'actor-id': actorId }embebida en el objeto para trazabilidad
3. Bandwidth y quota guards
Verificados en presign() antes de generar la URL. Si alguno falla, se devuelve 403:
| Guard | Límite | Previene |
|---|---|---|
| Uploads pendientes por actor | 3 | Presign cycling |
| Quota diaria confirmada | 50 MB/día | Bandwidth abuse |
| Uploads confirmados totales | 50 | Bucket bloat |
| Límite horario por propósito | avatar: 5/h, post_media: 20/h | Rapid-fire uploads |
Estos límites son configurables por propósito. Un avatar necesita controles más estrictos que una imagen de post.
4. Validación con magic bytes
En confirm(), se leen los primeros 12 bytes via GetObject Range y se comparan contra firmas conocidas:
| Tipo | Firma |
|---|---|
| JPEG | FF D8 FF |
| PNG | 89 50 4E 47 |
| WebP | RIFF + bytes 8-12 = WEBP |
| GIF | GIF87a o GIF89a |
¿Por qué post-upload? Porque no puedes validar magic bytes antes de que el archivo esté en el bucket. Una vez subido, descargar 12 bytes es trivial. Si el contenido real no coincide con el content_type declarado, se rechaza y se borra el archivo de R2.
5. Protección contra decompression bombs
Una imagen comprimida puede ser pequeña en disco pero expandirse a resoluciones masivas al descomprimirla. Un PNG de 100KB podría representar 100,000 × 100,000 píxeles que ocuparían 40GB en memoria.
Sharp tiene limitInputPixels que previene esto verificando el límite antes de descomprimir:
sharp(buffer, { limitInputPixels: 25_000_000 }) // ~25 megapixels maxPlus un hard check: si width > 4096 o height > 4096, se rechaza directamente. Nunca explota en memoria porque Sharp verifica el límite antes de intentar descomprimir.
6. Protección contra GIF frame bombs
Un GIF frame bomb contiene cientos de frames de 1×1 píxel. El archivo es pequeño, pero al procesarlo el servidor intenta renderizar miles de frames consumiendo CPU masivamente.
La solución: limitar el número de frames. Sharp extrae metadatos del GIF antes de procesarlo:
const metadata = await sharp(buffer).metadata();
if (metadata.pages && metadata.pages > 50) {
  throw new Error('GIF has too many frames');
}
Solo se decodifica el primer frame para inspección de metadatos. Si supera los 50 frames, se rechaza. La mayoría de GIFs animados útiles tienen menos de 30.
7. Stripping de EXIF y metadatos
Las fotos incluyen metadatos EXIF: ubicación GPS, modelo de cámara, timestamps, software. Si alguien sube una foto de su casa, podrías exponer su ubicación exacta si sirves la imagen original.
Todas las imágenes se re-encodifican a través de Sharp:
sharp(buffer)
  .rotate()              // Auto-rotates based on EXIF orientation
  .withMetadata({})      // Removes ALL EXIF, IPTC, XMP
  .resize(...)
.webp().rotate()— corrige la orientación basándose en EXIF antes de eliminarlo.withMetadata({})— elimina todos los metadatos del output- El output es siempre WebP — no se preserva el formato original. Esto simplifica todo: un solo formato para servir, un solo Content-Type, una sola lógica de caché
8. Prevención de XSS por Content-Type sniffing
Los archivos procesados se suben a R2 con headers determinados por el servidor, nunca por el usuario:
ContentType: image/webp          // server-determined
ContentDisposition: inline
CacheControl: public, max-age=31536000, immutable
En Cloudflare CDN, añade Transform Rules:
X-Content-Type-Options: nosniff
Content-Security-Policy: default-src 'none'
X-Frame-Options: DENY
Un detalle importante: sirve los archivos desde un dominio CDN separado de tu API (ej: cdn.tuapp.com vs api.tuapp.com). Cualquier XSS en el dominio CDN no tiene acceso a las cookies ni tokens de la API. Es aislamiento de seguridad por dominio.
9. Semáforo de procesamiento concurrente
Si múltiples usuarios confirman uploads simultáneamente, tu servidor podría procesar muchas imágenes en paralelo, cada una descargando hasta 5MB + buffers de Sharp. Esto puede agotar la memoria.
La solución es un semáforo que limita los procesamientos simultáneos (3 en este caso):
private activeConfirms = 0;
private readonly MAX_CONCURRENT_CONFIRMS = 3;
Si hay 3 procesamientos en curso, el cuarto recibe 429 Too Many Requests. El semáforo se libera tanto en éxito como en error.
10. Transiciones de estado atómicas
El flujo de status de un upload es: pending → processing → confirmed (o deleted).
La transición pending → processing usa un update condicional:
// UPDATE uploads SET status = 'processing' WHERE id = ? AND status = 'pending'
const claimed = await atomicSetStatus(id, 'pending', 'processing');
if (!claimed) throw new ConflictException('Already being processed');
Si otro request ya movió el status, el update afecta 0 filas y se rechaza. Esto previene race conditions de double-confirm: múltiples solicitudes idénticas producen el mismo resultado que una sola.
Image processing por propósito
El procesamiento varía según el propósito del upload:
| Propósito | Original | Thumbnail |
|---|---|---|
| avatar | Resize a 512px max, webp q85 | 128px, webp q80 |
| post_media | Sin tocar | 400px, webp q80 |
Para avatares, el original se sobrescribe con la versión procesada. El avatar anterior se borra de R2 para no acumular archivos huérfanos. El thumbnail se guarda como {original_key}_thumb.webp.
Orphan cleanup
Un cron job ejecuta cada 10 minutos:
- Encuentra uploads con status
pendingde más de 10 minutos - Borra los objetos de R2 (best effort)
- Elimina los registros de la base de datos
Esto captura los casos donde el cliente obtuvo una presigned URL pero nunca subió el archivo, o subió pero nunca confirmó. Sin este cron, los archivos pendientes se acumularían indefinidamente.
Edge cases conocidos
Race condition de quota: Dos llamadas simultáneas a presign() podrían pasar ambas el check de pending count antes de que ninguna guarde. Resultado: 4 pendientes en vez de 3. Impacto: insignificante (un upload extra). El throttle HTTP (10/min) limita la explotación.
Avatares duplicados confirmados: Si dos uploads pendientes de avatar para el mismo usuario se confirman casi simultáneamente, ambos tienen éxito y uno queda huérfano en R2. El cleanup cron solo maneja status pending. Un cron periódico para duplicados confirmados puede resolverlo si se convierte en problema.
Ninguno de los dos lleva a acceso no autorizado, pérdida de datos o abuso de facturación.
Testing
Los tests unitarios con mocks del S3Client cubren todas las capas de seguridad:
- Presign: genera URL, guarda registro, rechaza tipos no permitidos, devuelve 503 si R2 no está configurado
- Bandwidth guards: rechaza al alcanzar max pending, quota diaria, límite horario por propósito
- Confirm: DB lookup primero (sin llamar a R2 si ID no existe), verifica ownership, previene double confirm vía atomicSetStatus, valida magic bytes y rechaza spoofing, detecta GIF frame bombs, detecta decompression bombs, genera thumbnail y actualiza entidad, libera semáforo en error
- Delete: verifica ownership, borra de R2, aplica fallback para avatares eliminados
- Cleanup: encuentra uploads expirados, borra de R2 y DB
Los tests de guards son los más críticos — son tu red de seguridad contra abusos. Si un guard falla silenciosamente, estás expuesto.
Infrastructure (Cloudflare)
| Setting | Valor recomendado |
|---|---|
| Bucket | Tu bucket de uploads |
| Acceso público | Custom domain con proxy (orange cloud) |
| R2.dev | Deshabilitado (nunca exponer) |
| CORS | Solo tu dominio frontend, AllowedMethods: PUT |
| Cache Rule | Respetar Cache-Control: immutable del origen |
| Response headers | nosniff, CSP: default-src ‘none’, X-Frame-Options: DENY |
| DDoS | Activado (default en dominios con proxy) |
En desarrollo sin R2 configurado, el provider devuelve null y todos los endpoints responden con 503 Service Unavailable. La app arranca sin R2 — no hay dependencia hard.
Conclusión
Un sistema de upload en producción no es un endpoint. Es un pipeline con múltiples capas de seguridad: autenticación, scoping de URLs, bandwidth guards, validación de magic bytes, protección contra decompression bombs y GIF frame bombs, stripping de EXIF, prevención de XSS, semáforo de concurrencia, y transiciones atómicas de estado.
La mayoría de tutoriales se detienen en «genera una presigned URL y sube». Eso te funciona hasta que no funciona. Los ataques reales no aparecen en los ejemplos, y la diferencia entre un upload que funciona y uno que escala está en los detalles que este artículo cubre.
R2 te da el almacenamiento barato. Las capas de seguridad son tu trabajo.