De la teoría a la producción: un vault de Markdown como segunda memoria del agente, sincronizado de extremo a extremo, y un cron de madrugada que consolida lo aprendido sobre el modelo de memoria de agentes de Anthropic.
Un agente que olvida todo a las 9 de la mañana
Le pregunté a mi agente de IA si recordaba la decisión que tomamos ayer sobre el deploy. La respuesta fue desconocimiento total, sin matiz, sin «supongo que». Cada conversación empieza de cero, sin importar cuántas horas hayamos trabajado antes.
El problema es estructural: un modelo de lenguaje no guarda memoria entre sesiones. Lo que aprende dentro de la conversación (in-context learning) se pierde al cerrarla, y el compaction, que resuelve los contextos largos, es un resumen de la misma ventana, no persistencia. El modelo es el motor; el almacén hay que construírselo aparte.
Lo que buscaba tenía tres requisitos:
- Una base de conocimiento que yo pudiera leer, editar y curar a mano.
- Un agente que la actualizara solo, sin que yo dictara cada nota.
- Que sobreviviera a las sesiones: mañana se leyera lo mismo que ayer escribimos.
De esos tres requisitos salieron las dos piezas del montaje: un vault de Obsidian en el servidor y un proceso nocturno que consolida la memoria de agentes y le hace dormir.
¿Qué es el vault AI?
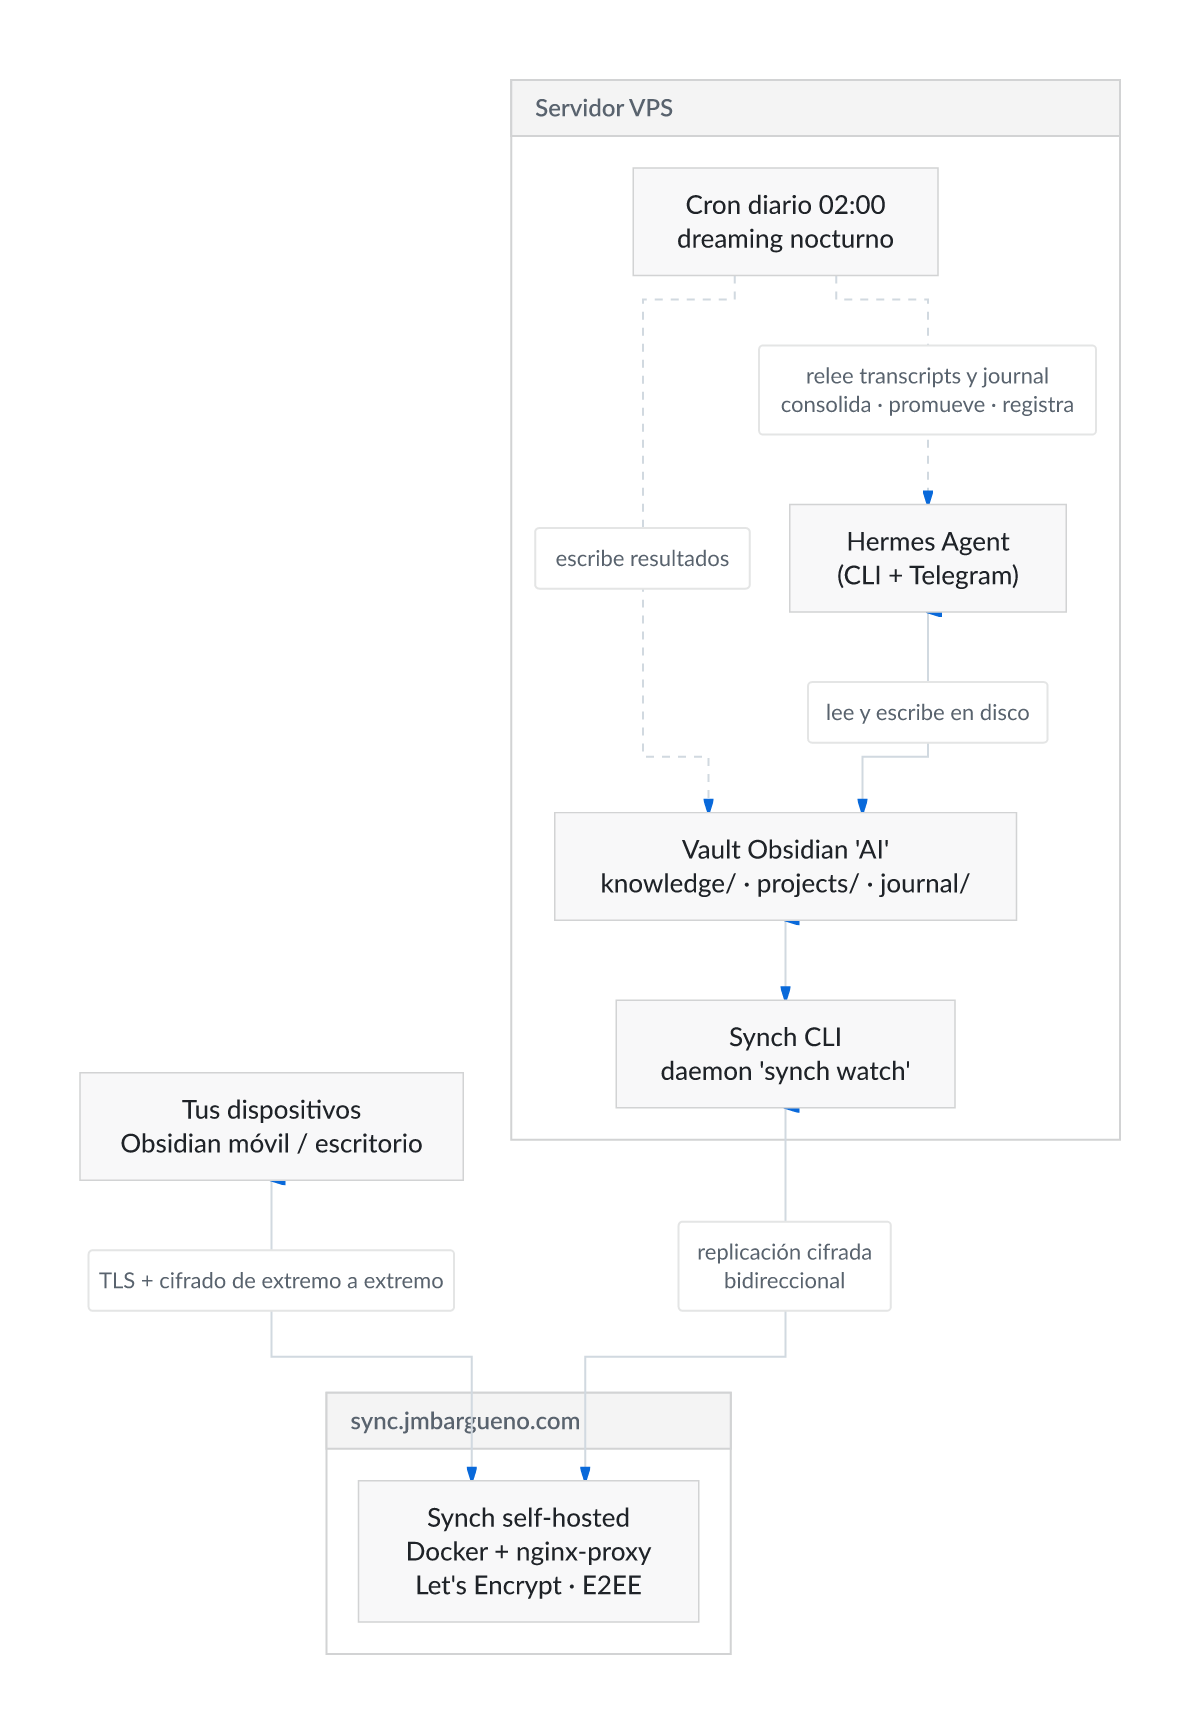
El vault AI es un directorio de Markdown en el servidor, con tres carpetas y un índice, que funciona como memoria intermedia entre los transcripts brutos de cada conversación y el contexto que se inyecta en cada sesión. Obsidian es la puerta de entrada para mí; los archivos planos en disco son la fuente de verdad para el agente.
Elegí Markdown por lo aburrido que es: se difusiona, se versiona, se lee sin API y cualquier herramienta lo entiende. Elegí Obsidian por el resto: grafo de enlaces, edición desde cualquier dispositivo y una curaduría que va en los dos sentidos. Si yo edito una nota, esa edición manda en la siguiente sesión del agente, y eso cambia por completo la relación con tu asistente: deja de ser un cuaderno de bitácora que nadie lee y pasa a ser una memoria compartida.
Hay un detalle que parece menor y no lo es: el vault no guarda secretos. Un token escrito en una nota viaja cifrado, pero yo lo leo en Obsidian sin esfuerzo. E2EE protege el tránsito, no a las notas que el propietario puede abrir. Por eso las credenciales viven fuera, en ficheros con permisos restringidos.
La estructura: tres carpetas, un índice y unas reglas
| Carpeta | Qué va dentro |
|---|---|
knowledge/ | Conocimiento durable: un tema, un procedimiento o una lección por nota |
projects/ | Proyectos activos: estado, decisiones y cómo relanzarlos |
journal/ | Registro diario AAAA-MM-DD.md: qué se hizo, qué se decidió, qué se aprendió |
Home.md es el índice (lo que en Obsidian se llama MOC, map of content): enlista las notas y las agrupa por área a medida que el vault crece.
Las convenciones son pocas y estrictas, y son la parte que de verdad sostiene el sistema:
- Una nota por idea. O por proyecto, o por día. Nunca dos temas en un archivo.
[[wikilinks]]para relacionar notas entre sí.- Frontmatter mínimo:
tagsy fecha. - Regla de conflictos: si una nota y una sesión se contradicen y la nota es una edición mía, la nota manda. El agente solo corrige una nota cuando la sesión demuestra claramente que está caduca.
El agente escribe el journal todos los días y solo sube a knowledge/ o projects/ lo que merece ser durable. La diferencia no es el volumen que escribe, es el criterio con el que decide.
De dónde salió el esquema: la memoria de agentes según Anthropic
Anthropic publicó en marzo de 2026 un artículo sobre los componentes de la memoria de agentes, The components of agent memory. Describe la memoria como una jerarquía de cuatro capas, de lo más efímero a lo más persistente:
| Capa | Qué es | Dónde vive en este montaje |
|---|---|---|
| Transcripts | Registro bruto de las conversaciones | Base de datos de Hermes, buscable por el agente |
| Notas de memoria | Observaciones escritas a propósito | knowledge/, projects/, journal/ del vault |
| Representaciones | Índice que ordena las notas | Home.md + wikilinks |
| Contexto inyectado | Lo que se carga en cada sesión sin buscarlo | Memoria MEMORY/USER del agente + skills |
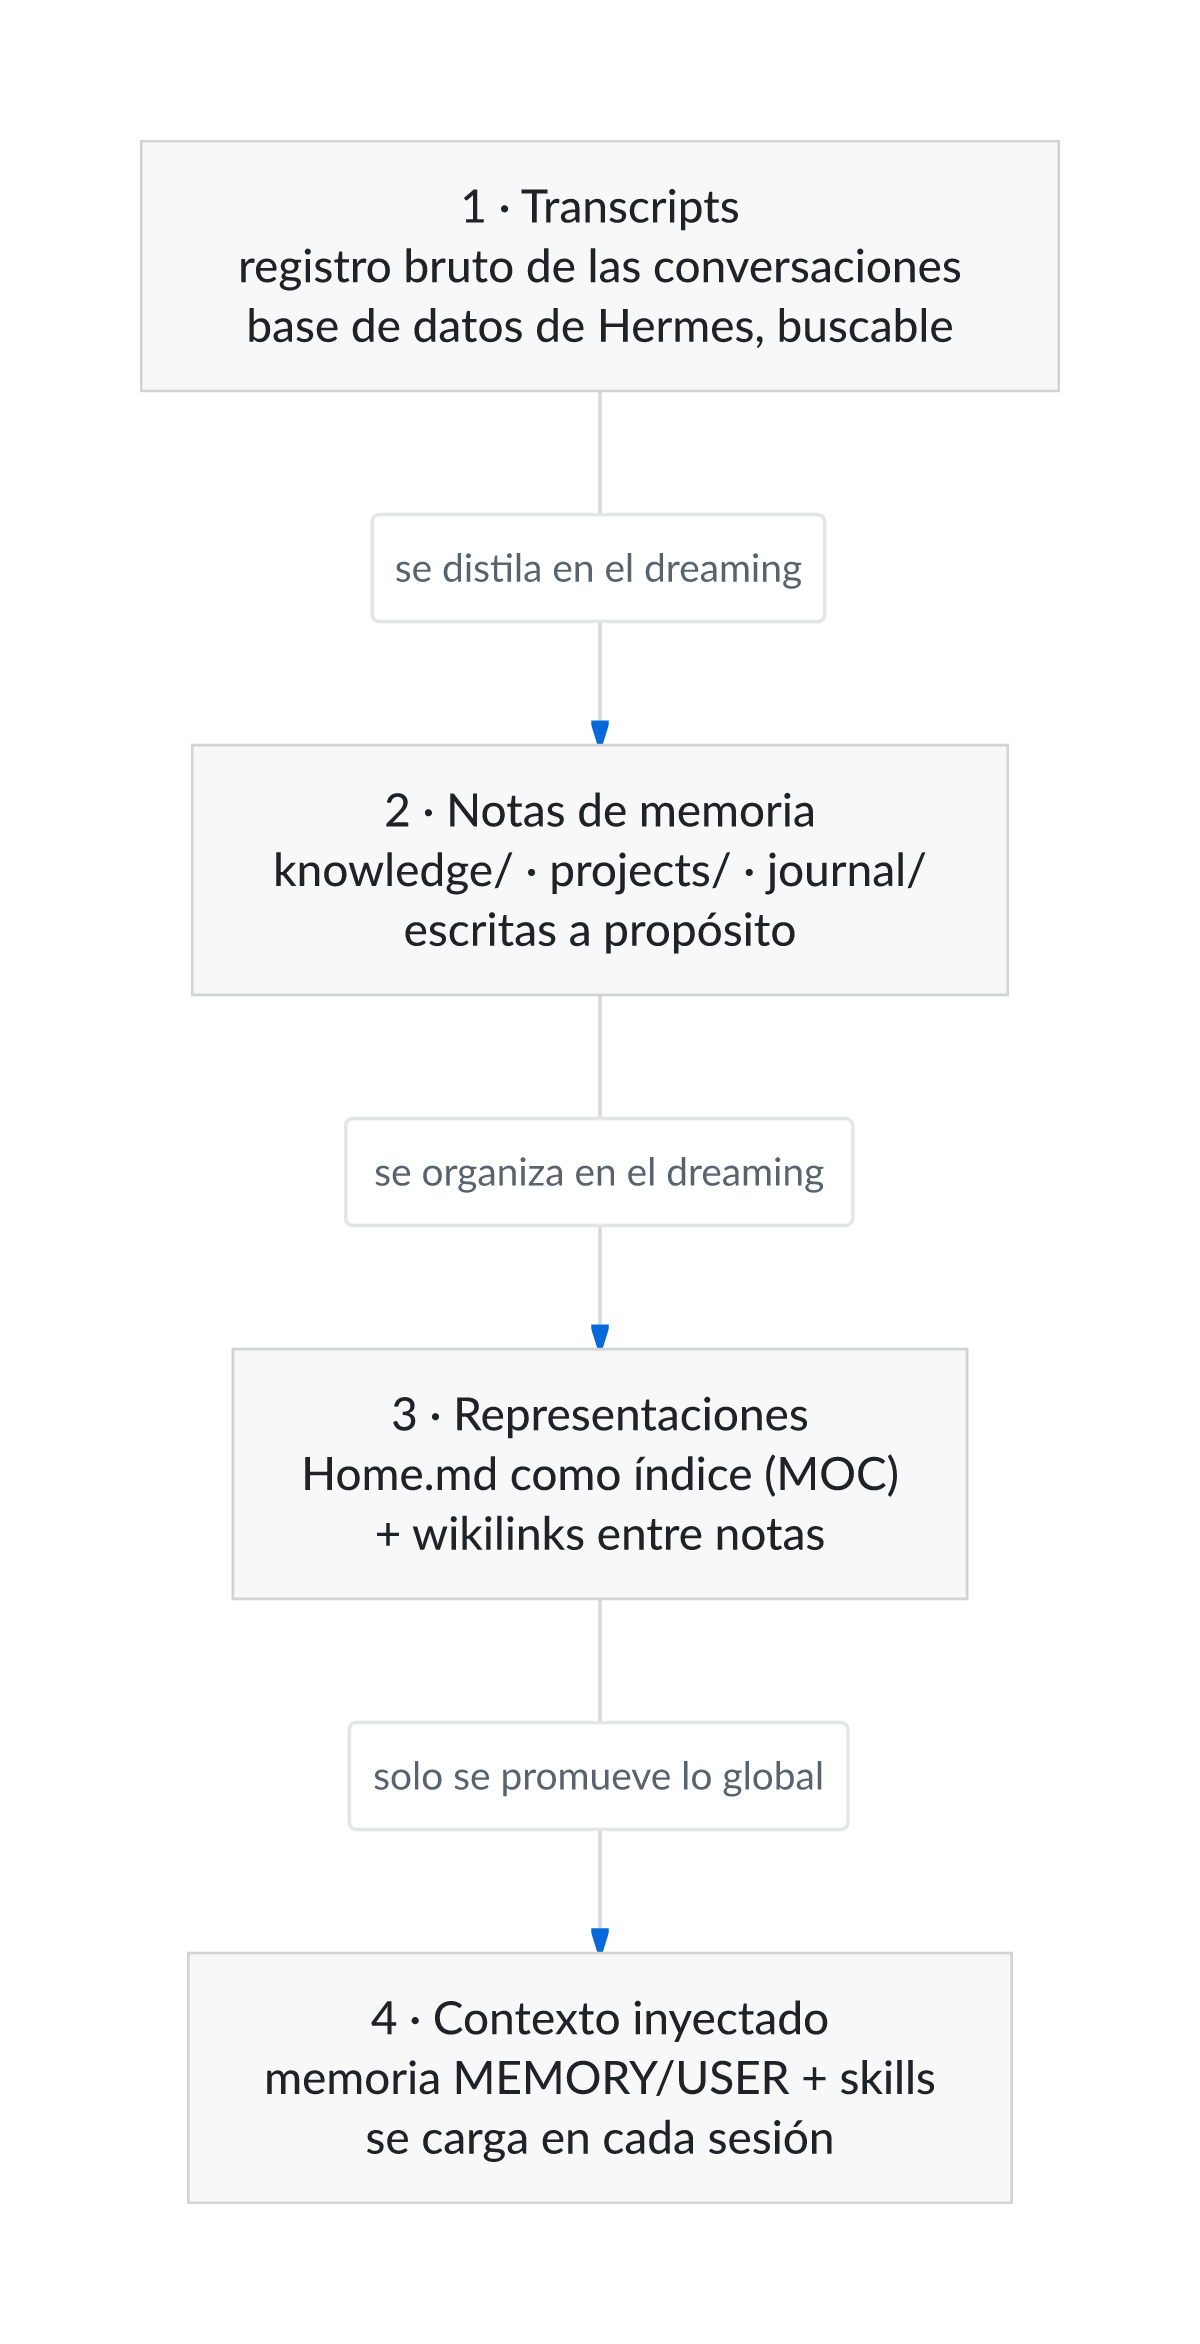
Dos ideas del artículo se me quedaron pegadas. La primera es el sleep-time compute: el agente puede procesar offline lo que capturó en línea, y no hace falta estar en conversación para que su memoria mejore. La segunda es la analogía que usan, hipocampo y neocórtex: en sesión se captura rápido y se archiva de golpe; offline se distila, se ordena y se promueve lo que importa.
El resto del artículo sirve para acotar bien lo que la memoria no es, porque se repite mucho el error: no son los pesos del modelo, que no se modifican; no es el in-context learning, que muere con la sesión; y no es el compaction, que es un resumen dentro de la misma ventana. Todo lo que es memoria de verdad es un archivo, y un archivo se puede organizar.
El dreaming: el agente duerme a las 2 de la madrugada
El dreaming es un cron diario que consolida la memoria de agentes a las 02:00, hora de Madrid, con su job dedicado. El agente relee los transcripts y el journal de las últimas 24-48 horas y pasa por un pipeline de seis pasos:
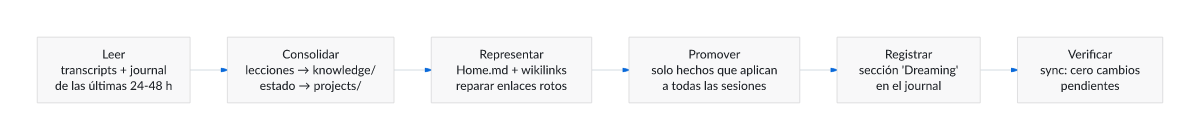
- Leer. Transcripts desde el último dreaming, journal y lista de notas existentes, para saber qué hay antes de crear nada.
- Consolidar. Lecciones durables nuevas a
knowledge/; si el tema ya existe, se extiende la nota, no se duplica. Cambios de estado de proyecto aprojects/. - Representar.
Home.mdse actualiza con las notas nuevas, se reparan wikilinks rotos y se vigila a las notas huérfanas, las que nadie enlaza. - Promover. Solo los hechos que aplican a todas las sesiones suben al contexto inyectado. Todo lo demás se queda en el vault, a mano para buscarlo cuando haga falta.
- Registrar. Una sección de dos o tres líneas en el journal: qué se consolidó, qué se corrigió, qué se promovió. Si no hubo cambios, se registra que no hubo cambios.
- Verificar. El sync debe cerrar con cero cambios pendientes; si no, el sueño no termina hasta que termina.
La promoción es el paso que más cuidado exige, y es el que diferencia un dreaming de un dump. El contexto inyectado tiene presupuesto duro, unos 2.000 caracteres; antes de añadir una línea, se parcha o se elimina una entrada caduca. Por eso el criterio es estricto: un hecho solo sube si aplica a todas las sesiones, no a una.
Los guardrails son pocos y duros. Toda escritura tiene que salir de una sesión, del journal o de una nota existente: el dreaming nunca inventa contenido. No hay contraseñas ni tokens en notas. No se reescribe una nota que el usuario esté editando; se crea otra o se añade al final. Y el alcance es el de una noche: las últimas 24-48 horas más la higiene estructural del vault, no una auditoría completa.
Sync en la nube: Synch autoalojado
Para que el vault se pueda editar desde el móvil mientras el agente lo escribe en el servidor, monté Synch autoalojado en la misma máquina. El cifrado es de extremo a extremo, así que el servidor solo ve cifrado.
En el servidor corre un daemon (synch watch) sobre el vault, y en mis dispositivos el cliente de Obsidian con Synch de fondo. La consecuencia práctica es un ciclo que se cierra cada día:
- Edito una nota en el móvil a las 11 de la noche.
- La siguiente sesión del agente la lee y la respeta.
- A las 2 AM el dreaming escribe sus resultados en el vault.
- A las 8 AM reviso en Obsidian lo que el agente soñó y lo corrijo si toca.
Los límites, puestos en claro
Cualquier sistema de memoria tiene bordes, y estos son los de este:
- No toca los pesos del modelo. No es un fine-tuning: el conocimiento vive en disco y se lee en cada acceso.
- El dreaming mira atrás 24-48 horas. Lo más viejo solo sobrevive si ya estaba en una nota; un tema que se dejó de cuidar no se recupula solo.
- El contexto inyectado cabe poco. La mayor parte del conocimiento no se inyecta nunca: vive en el vault y se busca cuando hace falta.
- Es memoria compartida. Mis ediciones mandan, y a veces lo que mando es corregir al agente.
Cómo lo montarías tú: cuatro pasos
- Un agente en un servidor que puedas dejar solo. Sesiones persistentes, terminal y tareas programadas. El agente concreto da igual; lo que importa es que dure más que una pestaña.
- Un vault de Markdown. Un índice (MOC), las tres carpetas y la convención de una nota por idea. Empieza pequeño: una semana solo de journal es suficiente para que el primer dreaming tenga materia real.
- Sync bidireccional y cifrado hacia tus dispositivos. La curaduría a mano es lo que convierte un log del agente en una memoria tuya.
- Un cron nocturno con el pipeline de leer, consolidar, representar, promover, registrar y verificar. La regla de promoción estricta es la que impide que el contexto inyectado se convierta en vertedero.
Preguntas frecuentes
¿El dreaming inventa contenido?
No. Toda escritura tiene que tener sustento: una sesión, el journal o una nota existente. Si no hay nada que consolidar, el registro dice «sin cambios» y termina ahí.
¿Por qué no inyectar todo el vault en cada sesión?
Porque el contexto inyectado tiene presupuesto duro y coste. Lo que no se inyecta no se pierde: el agente lo busca en el vault cuando hace falta.
¿Puedo editar las notas sin romper nada?
Sí. El sync es bidireccional y de extremo a extremo, y la regla de conflictos es sencilla: si una nota y una sesión se contradicen, la edición que hiciste a mano manda.
¿Dónde están las contraseñas y tokens?
Fuera del vault. El vault es legible en Obsidian, así que los secretos viven en ficheros con permisos restringidos en el servidor.
¿Y si no uso Obsidian?
El vault es Markdown plano. Lo lee y lo escribe el agente, y tú puedes curarlo con cualquier editor, con git o directamente desde el sistema de archivos.
Este post lo escribí con el stack que describe: el dreaming de la madrugada de hoy consolidó esta sesión en el vault mientras yo revisaba el borrador. Si quieres el detalle de alguna pieza, el guardrail de correo o el sync en profundidad, dímelo y lo montamos en un próximo post.