Todo segundo cerebro que he visto morir muere de la misma causa: no por falta de capturas, sino por falta de mantenimiento. Llenas las carpetas, creas los enlaces, y un día notas que la última vez que abriste el wiki fue hace tres semanas. La curaduría se convierte en un trabajo que nadie quiere hacer, y el vault se convierte en un archivo fúnebre.
El LLM Wiki de Andrej Karpathy ataca justo ese punto. La idea tiene una explicación larga y un giro corto: en lugar de que el LLM busque tus notas cuando le preguntas (el modelo RAG), el LLM escribe y mantiene un wiki persistente que ya contiene la síntesis. El conocimiento se compila una vez y luego se mantiene actualizado, no se re-deriva en cada consulta.
Este mes lo monté sobre mi vault, con Obsidian y un agente que trabaja sobre el servidor. Te cuento qué es, cómo funcionan sus tres capas, las cuatro operaciones que lo hacen andar, y lo que publiqué como repo público para que puedas montar el tuyo.
¿Qué es el LLM Wiki?
En abril de 2026, Karpathy publicó un gist corto que describe como un patrón para construir bases de conocimiento personales con LLMs. El documento es deliberadamente abstracto: no es una implementación, es un archivo de ideas diseñado para pasárselo a tu propio agente (Claude Code, Codex, OpenCode…) y que ambos, a partir de ahí, instancien juntos la versión que encaje con tu dominio.
El giro central es un cambio de roles. El LLM no consulta tus notas: escribe y mantiene todo el wiki. Tú no escribes el wiki (o casi nunca). El LLM hace todo el trabajo pesado: resumir, cruzar referencias, archivar, llevar la contabilidad. Tu trabajo es curar las fuentes, dirigir el análisis y hacer buenas preguntas.
Karpathy describe su propio setup con una fórmula que me gusta: Obsidian es el IDE, el LLM es el programador, y el wiki es el codebase. En la práctica, tiene el agente abierto en un lado y Obsidian en el otro, editando en base a la conversación y navegando los resultados en tiempo real, siguiendo enlaces, mirando la vista de grafo y leyendo las páginas actualizadas.
La diferencia real con RAG
La mayoría de las herramientas de «charlar con tus notas» funcionan así: a la hora de la pregunta recuperan fragmentos relevantes y generan la respuesta desde cero. Funciona, pero el LLM está redescubriendo el conocimiento en cada pregunta. No hay acumulación. Pregúntale algo sutil que requiera sintetizar cinco documentos y el LLM tiene que encontrar y encajar los fragmentos otra vez, en cada pregunta. Nada se construye.
El LLM Wiki invierte eso. En lugar de recuperar documentos crudos en el momento de la consulta, el LLM construye y mantiene de forma incremental un wiki persistente: una colección estructurada y enlazada de archivos markdown que se sitúa entre tú y las fuentes crudas. Cuando añades una fuente nueva, el LLM no la indexa para recuperar más tarde: la lee, extrae la información clave y la integra en el wiki existente, actualizando páginas de entidades, revisando resúmenes y anotando dónde los datos nuevos contradicen afirmaciones viejas.
La clave es que el wiki es un artefacto persistente que acumula valor:
- La síntesis está precomputada. La página «qué sé sobre X» ya existe, escrita con cuidado, y se actualiza cuando llega una fuente nueva. No re-sintetizas en cada consulta.
- Las referencias cruzadas son explícitas. Cuando preguntas por una cosa, la página enlaza a las notas relacionadas, no a vectores en un espacio de embeddings.
- Puedes leerlo. El segundo cerebro es inspeccionable sin modelo: es un directorio de markdown.
Es la diferencia entre «tengo un buscador sobre mis archivos» y «tengo un artefacto de investigación que acumula».
Las tres capas
Karpathy describe tres capas. En mi vault, cada una tiene un homólogo concreto:
| Capa | Qué es | En mi vault |
|---|---|---|
| Fuentes crudas | Artículos, papers, gists. Inmutables: el LLM las lee y nunca las edita | sources/, nombradas AAAA-MM-DD-slug.md |
| El wiki | Archivos markdown escritos por el LLM: resúmenes, páginas de concepto, comparativas | knowledge/ (una nota por tema), projects/ y journal/ |
| El schema | El documento que le dice al LLM cómo está estructurado el wiki y qué convenciones seguir | Home.md como índice + las skills del agente |
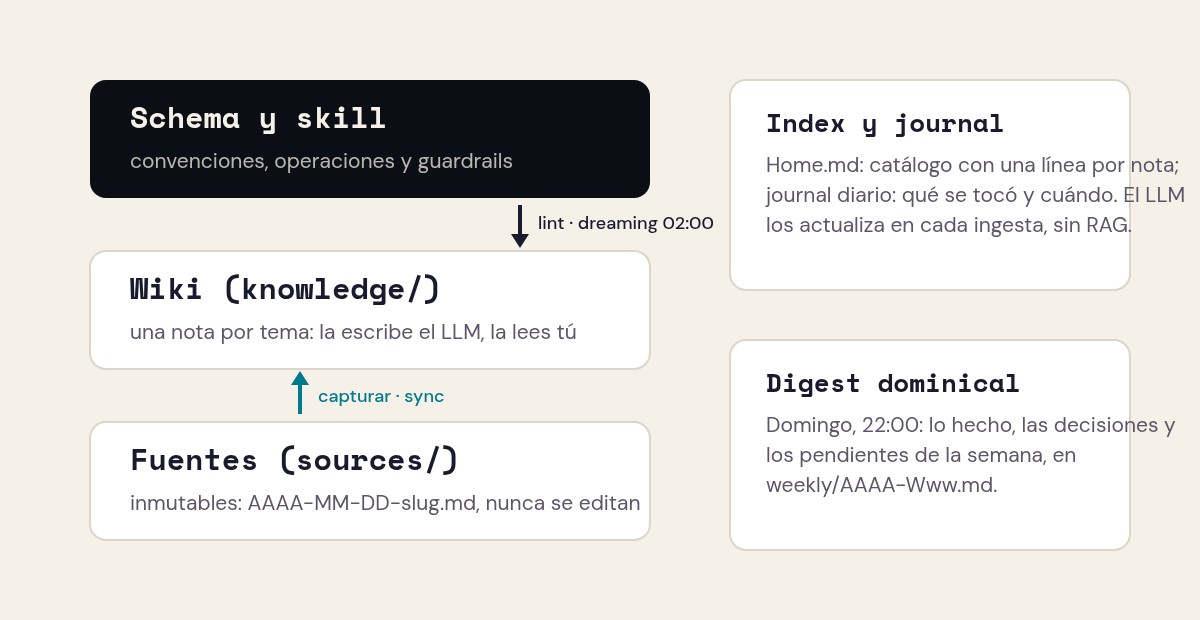
La capa más importante no es la que navegas, es el schema. Es lo que convierte al LLM de chatbot genérico en un mantenedor disciplinado del wiki. El mío fija las convenciones de nombres, el frontmatter, la regla de conflictos y las operaciones disponibles. Karpathy lo llama el fichero de configuración clave, y lo co-evolucionas con el LLM a medida que descubres qué funciona en tu dominio.
Los dos ficheros especiales que menciona están también en mi setup: un índice (en mi caso, Home.md) con una línea de resumen por nota, y un log (en mi caso, el journal diario). Según el gist, el índice solo funciona sorprendentemente bien a escala moderada, unas centenas de páginas, y evita la infraestructura RAG basada en embeddings.
El cambio de mentalidad
Aquí está el giro mental que hace que el sistema funcione, y no es de herramientas: deja de pensar en estas notas como tuyas. Son notas que la IA guarda por ti. Tú diriges, preguntas y decides qué investigar; el agente hace el trabajo editorial de extraer, resumir, cruzar enlaces, deduplicar y actualizar.
Ese volteo es el que justifica el schema. Un humano que «simplemente escribe un poco» acaba por no escribir nada, y el wiki muere otra vez. Un agente con reglas documentadas escribe cada vez, en cada operación, sin cansarse. Eso no es un truco de productividad: es la división de trabajo que el método propone de verdad.
Las cuatro operaciones
El gist define tres operaciones, ingest, query y lint, y el artículo que popularizó el método las operacionaliza como cuatro skills. Son las cuatro operaciones del LLM Wiki que uso yo:
- capture. Soltas una fuente (URL, PDF, gist) y el agente la procesa: la guarda tal cual en
sources/con la URL y la fecha, escribe la nota de síntesis, actualiza el índice y toca las notas relacionadas. Una sola fuente puede tocar entre 10 y 15 notas. - sync. Has leído algo y entra en el vault: el agente integra la conversación en las notas, extendiendo las que ya existen en lugar de duplicarlas.
- lint. Revisión de salud: contradicciones entre notas, afirmaciones caducas, notas huérfanas, referencias que faltan. El agente no silencia discrepancias: si dos notas dicen cosas opuestas, la deja anotada y decides tú.
- digest. Síntesis semanal: lo hecho, las decisiones, los pendientes. En mi caso cierra la semana los domingos.
En mi setup, el lint no es un comando que escribes, es un proceso nocturno: cada día a las 02:00 el agente repasa las sesiones del día, actualiza las notas, repara enlaces rotos y deja un journal. El detalle de ese mantenimiento nocturno, el pipeline de seis pasos, las reglas de promoción y los guardrails, lo conté en este artículo anterior.
El gist cierra con una idea que vale la pena subrayar: las buenas respuestas pueden archivarse de vuelta en el wiki como páginas nuevas. Una comparativa que pediste, un análisis, una conexión que descubriste: son valiosos y no deberían perderse en el historial del chat. Así, tus exploraciones acumulan en la base de conocimiento igual que las fuentes ingesta.
No solo para un vault personal
El gist es agnóstico al dominio, y Karpathy lista varios usos:
- Personal: seguir tus propios objetivos, salud y auto-mejora: entradas de diario, artículos, notas de podcasts.
- Investigación: profundizar en un tema durante semanas o meses: papers, informes, una tesis que evoluciona.
- Leer un libro: fichar cada capítulo mientras lees, con páginas para personajes, temas y hilos argumentales. Al final tienes un wiki compañero personal, en el espíritu de un Tolkien Gateway.
- Negocio o equipo: un wiki interno alimentado por hilos de Slack, actas de reuniones y documentos de proyecto, con humanos en el bucle revisando las actualizaciones.
- Due diligence, planes de viaje, apuntes de curso: cualquier cosa donde acumules conocimiento con el tiempo y lo quieras organizado en lugar de disperso.
Mi uso es el más personal de la lista, la memoria del propio agente más lo que yo leo, pero el patrón no cambia en ninguno: tres capas, un schema, operaciones, y un mantenimiento que no es tuyo.
Lo publiqué como repo
Cuando el sistema funcionaba, lo documenté como una skill instalable en GitHub. El repo trae el layout del vault, las cuatro operaciones, las ground rules (fuentes inmutables, una nota por tema, los secretos fuera del vault) y los dos prompts listos para adaptar a cualquier agente: el dreaming nocturno y el digest dominical.
Lo publiqué en inglés porque el público del método de Karpathy es anglófono, y sin nada específico de mi setup: sin paths, sin credenciales, sin referencias a mis herramientas. Es el patrón, no mi casa. Lo instalas en tu agente y empiezas una conversación sobre qué versión encaja contigo.
Cómo lo montarías tú
Cuatro pasos para montar tu propio LLM Wiki, en orden:
- Un vault de markdown. Tres carpetas:
sources/(cruda, inmutable),knowledge/(síntesis) y un índice. Una nota por idea. Empieza pequeño: una semana solo de journal es suficiente para que el primer sync tenga materia real. - Un schema en un documento. Convenciones de nombres, frontmatter, regla de conflictos, operaciones. No hace falta escribirlo entero de golpe: escribe una primera versión y deja que el agente te proponga lo que falta cada vez que trabaja sobre el vault.
- Un agente que pueda leer las sesiones. Sesiones persistentes, terminal y tareas programadas. El agente concreto da igual: lo que importa es que dure más que una pestaña y que escriba markdown.
- Un cron nocturno y un digest semanal. El agente lee el día, actualiza las notas, repara lo roto y escribe un journal. El digest semanal cierra el bucle: es lo que convierte las notas en una imagen de la semana.
Obsidian ayuda pero no es obligatorio: la vista de grafo es la mejor manera de ver la forma del wiki, qué está conectado con qué, qué páginas son hubs y cuáles son huérfanas, pero el vault es markdown plano, y eso es todo lo que el agente necesita. Y el wiki es, a fin de cuentas, un repo de git: historial de versiones, ramas y colaboración de gratis.
Lo que no es
Antes de cerrar, los bordes:
- No es RAG, pero tampoco excluye la búsqueda. A escala, el gist recomienda añadir un buscador local sobre las notas; a escala moderada, el índice es suficiente.
- No es un fine-tuning. Los pesos del modelo no cambian: el conocimiento vive en disco y se lee en cada acceso.
- El LLM no es un oráculo. La curaduría de las fuentes y la última palabra sobre una contradicción son tuyas. La regla del agente es no silenciar discrepancias: las deja anotadas y decides tú.
- El vault no guarda secretos. Lo que está en una nota lo lees en Obsidian sin esfuerzo; las credenciales viven fuera, en ficheros con permisos restringidos.
- No recupera lo que abandonaste. El mantenimiento nocturno mira atrás 24-48 horas; un tema que se dejó de cuidar no se recupela solo.
Preguntas frecuentes
¿Necesito Obsidian?
No. El vault es markdown plano y el agente lo lee y lo escribe directamente. Obsidian añade la vista de grafo y la edición desde cualquier dispositivo, pero el método no depende de él.
¿Y si dos notas se contradicen?
El lint detecta la contradicción y la deja anotada, en la nota y en el journal. No elige un bando: tú decides cuál tiene razón, y el agente actualiza el resto.
¿Cada cuánto hay que hacer lint?
En mi setup, a diario, a través del dreaming nocturno, más el digest dominical. Si usas las operaciones como comandos, una vez por semana es un mínimo razonable para un vault de tamaño medio.
¿Qué pasa cuando el vault llega a 500 páginas?
El gist dice que el índice funciona bien hasta unas centenas de páginas, y a partir de ahí se añade un buscador sobre las notas. Es una evolución, no un rediseño: las tres capas del LLM Wiki no cambian.
¿Dónde guardo las contraseñas y los tokens?
Fuera del vault. El vault es legible en cualquier editor, así que los secretos viven en el servidor, en ficheros con permisos restringidos.
Cierre
El LLM Wiki me dio algo que ningún método de notas me había dado antes: el mantenimiento dejó de ser mi trabajo. El wiki no muere de aburrimiento, el índice no se pone caduco y las notas huérfanas se reparan mientras duermo. Lo que yo hago es curar, preguntar y corregir.
Si quieres la versión lista, el repo está aquí; si quieres ver cómo funciona el mantenimiento nocturno en detalle, el artículo anterior lo cuenta paso a paso.